第03回 ばらつきを測る/正規分布という「仮定」
10/13(火)Ⅱ講 10:35〜12:15・B402教室
平均が同じでも、中身は別物 ―― 分散・標準偏差・偏差値、そして「正規分布」の責任
今日のリンク
- 📊 スライドを開く
- 📓 Colabノートを開く(03_variability.ipynb)
- 📝 課題を提出する(Moodle・第3回)
- 課題の本文はこのページの末尾にあります
- 🤖 NotebookLMで復習する(この回の内容をAIに質問できます)
考え方をガイドで確かめる
この回の考え方は、統計の考え方ガイドの「データを要約する」でも解説しています。霊長類のデータを動かしながら確かめられます。
この回のゴール
- 分散・標準偏差が「何を測っているか」を説明できる
- 偏差値の正体(平均50・SD10に置き直した相対位置)を理解する
- 正規分布の 68-95-99.7 則を知り、「正規だと仮定してよいか」を自分で確かめる
- 発展:偏差の和が0になること、\( s^2 = \overline{x^2} - \bar{x}^2 \)、偏差値の平均が50・SDが10になることを、自分で導ける
到達目標との対応:G1(記述統計)。
第2回の答案から ―― 冒頭で確認すること
第2回の課題(代表値と外れ値)は、52名が提出し、記述は38名が満点だった。 全体としてよく書けていたが、減点した14名のつまずきは4つの型に分かれる。 どれも第3回(ばらつき)に直接ひびくので、先に確認しておく。
① いちばん多かった ―― 「とりあえず消すのが危険な理由」を書いていない(3名)
B2は3点を求めていた。除いてよい例、除いてはいけない例、そして 「外れ値はとりあえず消す」がなぜ危険か。3つ目を落とした答案が3名いた。
例が2つ書けていれば半分は書けている。だが設問が聞いていたのは、 判断の基準そのものである。答えを1文にすると、こうなる。
異常値(記録の誤り)と、本物の極端な値を区別せずに消すと、本物の情報まで失われる。 だから、消す前になぜその値が外れているのかを確かめる。
② 除いてよい/いけないの判定を取り違えた(4名)
内訳はこうだった。
| 書かれていたこと | どこが違うか |
|---|---|
| メルカリで10万円の出品は「相場に不相応だから除いてよい」 | 極端だから消すは、まさに禁じ手。その出品が実在するなら本物のデータ |
| ゴリラの149kgは「中央値から大きく離れているから除いてよい」 | 中央値から遠いことは理由にならない。149kgは本物の値 |
| 入力ミスを「除いてはいけない」側に書いた(2名) | 入力ミスは除いてよい側 |
判定の基準は「大きさ」ではない
除いてよいのは次の3つだけである。
- 欠測コード(−999 のように、情報がないことを表すために置かれた符号)
- 入力・測定の誤り(確認して訂正、訂正できなければ理由を明示して除外)
- 対象範囲の限定(「ヒト科を除く霊長類」のように目的と手続きを明示する)
「平均から遠い」「中央値から離れている」「極端だ」は、どれも理由にならない。 理由になるのは「その値が、測りたかったものを測れていない」という根拠である。
③ ヒト科を除いた比較を「外れ値除去の例」として引いた(2名)
授業で見た「ヒト科7種を除くと平均は1,754g動くが、中央値は209gしか動かない」は、 外れ値を除いた例ではない。上の③にあたる対象範囲の限定である。
- 外れ値除去:ある値を「おかしい」と判断して取り除く
- 対象範囲の限定:「ヒト科以外の霊長類」という別の集団を分析対象と決める
結論(平均は大きく動き、中央値はあまり動かない)は変わらない。 だがやった操作が違う。この区別ができていた答案も1件あった。
④ 与えられた数値を書き写し間違えた(1名)
課題のアルバイトの時給は 1,050円だったが、1,500円として議論した答案があった。 結論は変わらないが、代表値の話は「どの数字を代表させるか」なので、 元の数字は正確に写すことが前提になる。
第3回につながること
今日はばらつき(分散・標準偏差)を扱う。外れ値は、代表値よりも ばらつきに強く効く(二乗するので、遠い値の影響がさらに大きくなる)。 ①と②でつまずいた人は、今日の内容でも同じところで迷うことになる。
1. 平均だけでは、データは分からない
2か所の森で、サルの体重を30頭ずつ測った。どちらも平均6.0kg。同じような群れだろうか?
- 森A:ほとんどの個体が6kg前後(SD ≈ 0)
- 森B:半分が2kg、半分が10kg(SD ≈ 4.1)
平均は同じでも中身は正反対。平均は分布の「位置」しか表さない。 足りないのは「どれだけ散らばっているか」=ばらつきの情報だ。
森Bはそもそも2つの別々の集団が混ざっているのかもしれない(第2回の「二山」の話とつながる)。
何のばらつきを見ているのか
この森の例で測っているのは 1頭ずつの個体間のばらつきである。 一方、このあと使う PanTHERIA は 1行が1種なので、種と種のあいだのばらつきを見ることになる。 「妊娠期間のSDが37.8日」は、種によって妊娠期間がこれだけ違うという意味であって、 同じ種のメス個体ごとのばらつきではない。
なお森Aはコード上、全30頭がちょうど6.0kgでSDが0である。 SDが0のデータは偏差値を計算できない(0で割ることになる)。 「どんなデータでも平均50・SD10になる」は、元のSDが0でないときの話である。
2. 分散と標準偏差 ―― なぜ二乗するのか
分散が大きい/小さいとは ―― まず絵で見る
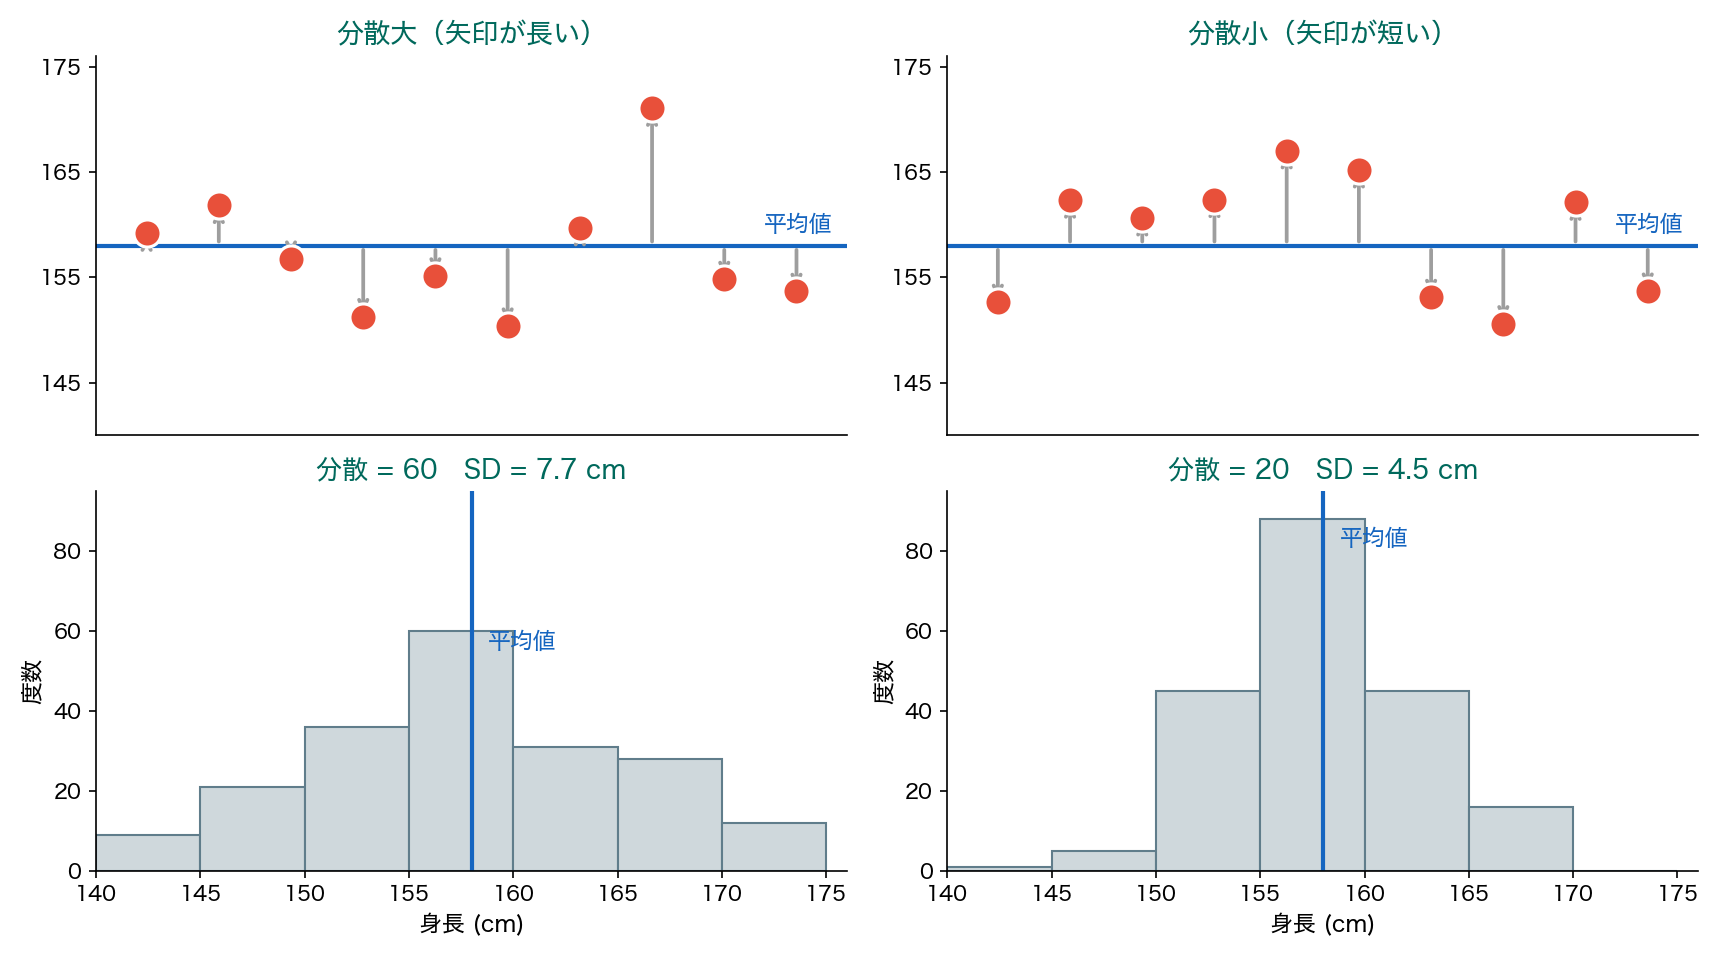
どちらも平均は 158cm で同じ。違うのは、平均の線から各データまでの矢印の長さだけである。 矢印が長い(左)と分散は60・SDは7.7cm、短い(右)と分散は20・SDは4.5cm。 下のヒストグラムを見ると、同じ平均でも広がり方がまるで違うことが分かる。
分散とは、この矢印の長さを数字ひとつにまとめたものである。
ばらつきは「各データが平均からどれだけ離れているか」で測る。
- 各データの 平均からの差(偏差) を出す
- そのまま足すと プラスとマイナスが打ち消し合って必ず0になる → 二乗してから平均する = 分散
- 二乗したままだと単位が「点²」で直感的でない → ルートを取って元の単位に戻す = 標準偏差(SD)
分散のイメージ ―― なぜ二乗が要るのか
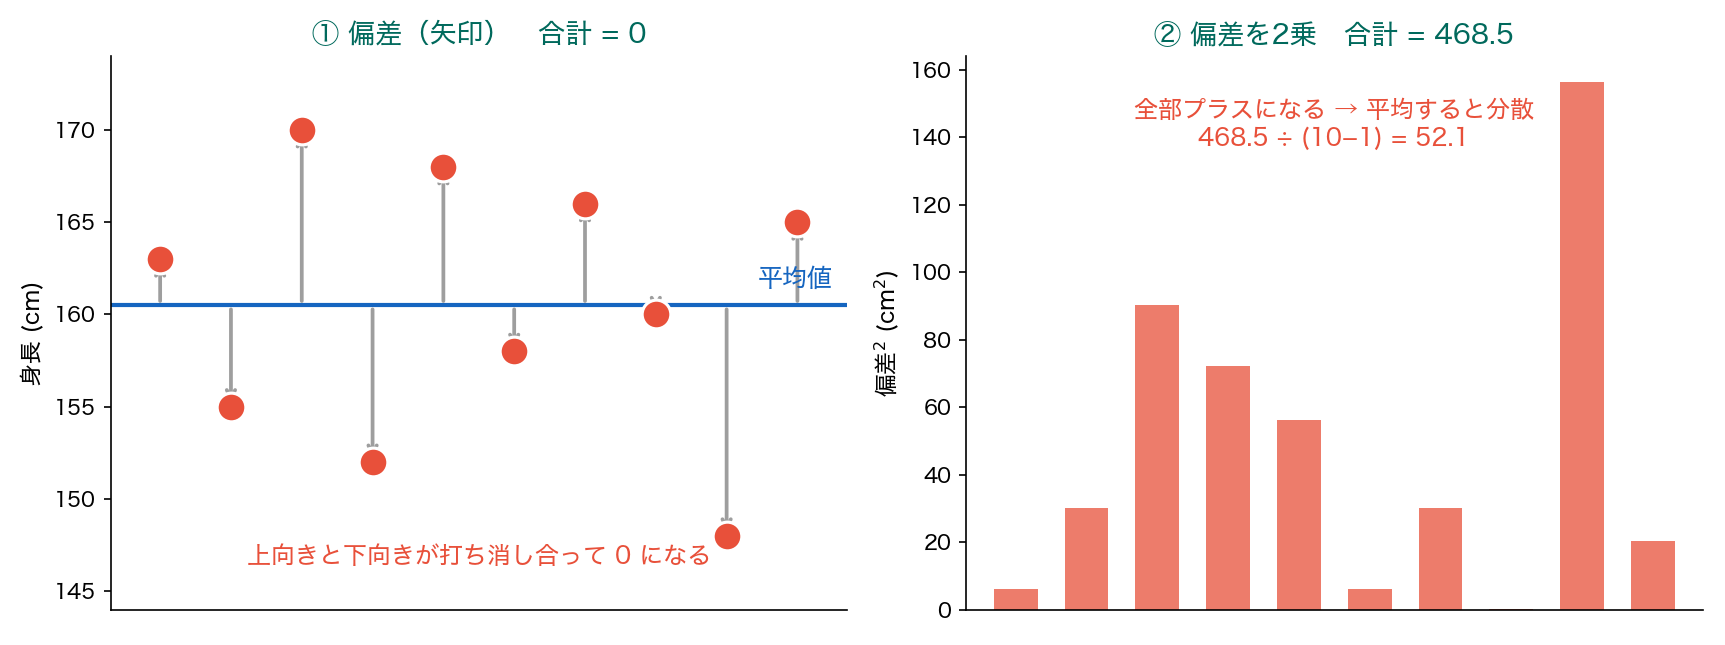
左が偏差(平均の線から各データまでの矢印)。上向きと下向きがあるので、 そのまま足すと打ち消し合って 0 になる。これでは「散らばりが大きいか小さいか」を測れない。
そこで右のように一つずつ二乗する。二乗すれば符号が消えて全部プラスになり、 しかも遠い点ほど重く効く(10cm離れた点は5cm離れた点の4倍になる)。 この二乗を全部足して、データ数−1で割ったものが分散である。
図の例では、二乗の合計が 468.5、データが10個なので \( 468.5 \div 9 = 52.1 \)。 要するに、矢印の長さの二乗を平均したものが分散だと思えばよい。
なぜ二乗? なぜルート?
二乗は「符号を消して、大きいズレをより重く見る」ため。ルートは「日²を日に戻して、人間が読める単位にする」ため。だから普段はSDを使う。
導出①:偏差の合計は、必ず 0 になる
「偏差をそのまま足すと0になる」のは、このデータがたまたまそうだったのではない。どんなデータでも必ずそうなる。
ここで平均の定義 \( \bar{x} = \frac{1}{n}\sum x_i \) を裏返すと \( \sum x_i = n\bar{x} \)。代入すれば
データがどれだけ歪んでいても、外れ値がいくつあっても、この和は0である。だから「偏差をそのまま平均する」という測り方は、ばらつきの指標として使いものにならない。 打ち消しを止める工夫が要る。
工夫は二乗だけではない。絶対値を取るという手もある(それが第2回で中央値につながった測り方だった)。ここで二乗を選ぶと、この先の分散・標準誤差・正規分布がきれいにつながる。
数値で確かめる:妊娠期間日(146種)で \( \sum (x_i-\bar{x}) = -3.4\times10^{-12} \)。厳密には0で、残っているのは計算機の丸め誤差である。
使った数学:総和の分配と平均の定義(微I)。
導出②:分散は「二乗の平均 引く 平均の二乗」でも出せる
分散の定義は「偏差の二乗の平均」である。
中身を展開してみる。
真ん中の \( \frac{1}{n}\sum x_i \) は \( \bar{x} \) そのものだから、第2項は \( -2\bar{x}^2 \) になる。まとめると
「二乗の平均 引く 平均の二乗」。データを1回なめるだけで \( \sum x_i \) と \( \sum x_i^2 \) を同時に貯められるので、電卓の時代や、大量のデータを一度しか読めない場面ではこちらが使われる。
数値で確かめる:妊娠期間日で、定義どおりの \( \frac{1}{n}\sum(x_i-\bar{x})^2 = 1417.4576 \)、展開形の \( \overline{x^2}-\bar{x}^2 = 1417.4576 \)。一致する。
n で割るか、n−1 で割るか
いま導いた \( s^2 \) は n で割る定義で、値は 1,417.46 である。ところが下の表の分散は 1,427.2。食い違っているのではなく、割る数が違う。表の値は n−1 で割る定義(不偏分散)で、pandas の var() はこちらを既定にしている。
146種では比が \( 146/145 \)、0.7%の違いでしかない。どちらを使うかは、手元のデータそのものを記述したいのか、背後の母集団を推定したいのかで決まる。推定の話は第7回、n−1 でなければならない理由は第8回で扱う。
使った数学:総和の分配と二項展開(微I)。
霊長類の 妊娠期間日(146種):
| 量 | 値 |
|---|---|
| 平均 | 164.4 日 |
| 分散 | 1,427.2(日²・読みにくい) |
| 標準偏差(SD) | 37.8 日(元の単位・これを使う) |
SDは「平均からの標準的な散らばり幅」。平均±1SD(約127〜202日)に多くの種が収まる。
ちなみにヒトの妊娠期間は約280日で、この平均から見ると +3SD ほど右にいる。霊長類の中ではかなり長いほうである。
3. 偏差値の正体
偏差値は、値を 平均50・標準偏差10 のものさしに置き直しただけ。
この操作には名前がある ―― 標準化
上の式の、分数の部分だけを取り出したもの
を 標準化(standardization)、\( z \) を z得点 という。平均0・標準偏差1に置き直す操作で、単位が消える(cmでも円でもgでも、z は無単位)。偏差値はこの z を 50+10z と読みやすく化粧しただけである。
この授業では、標準化がこのあと何度も出てくる。第5回(相関係数 r は標準化した2つの値の積の平均)、第6回・第7回(標本平均を標準化して正規分布に持ち込む)、第13回(単位の違う変数を主成分分析にかける前処理)。名前を覚えるのはここで一度だけでよい。
導出③:偏差値の平均が50・標準偏差が10になる理由
偏差値は、元の値 \( x \) を \( z = 50 + 10\cdot\frac{x-\bar{x}}{s} \) に置き換えたものである。よく見るとこれは \( x \) の一次式(\( ax+b \) の形)でしかない。
一次変換に対して、平均と標準偏差は次の規則に従う。
平均は足した分だけずれる。標準偏差は定数倍だけが効き、平行移動 \( b \) の影響を受けない。ばらつきは、全体をまるごと動かしても変わらないからである。
偏差値は \( a = 10/s \)、\( b = 50 - 10\bar{x}/s \) の一次変換だから、
どんなデータでも、必ず平均50・標準偏差10になる。テストが易しくても難しくても、受験者がどれだけ優秀でも、偏差値の平均は50である。偏差値が測っているのは学力の絶対量ではなく、その集団の中での位置だ、というのはこの式の帰結である。
そしてここが肝心な点だ。この導出には、分布の形が一度も出てこない。 だから歪んだデータに使っても、平均50・SD10という性質はそのまま保たれる。ゴリラの159.2も、式としては何も壊れていない。
壊れるのはその先――「偏差値60なら上位約16%」という読み替えのほうである。そこで初めて正規分布を仮定しているからだ。式が成り立つことと、意味が通ることは、別である。
数値で確かめる:妊娠期間日を偏差値に直すと、平均 50.000、標準偏差 10.000。丸め誤差の範囲で厳密に一致する。
使った数学:一次変換に対する平均と標準偏差の規則(微I)。
「平均からSD何個分ずれているか」を 50 中心に表したもの。これを霊長類の体重でやると、壊れる。
| 種 | 体重 | 生のスケール | 対数スケール |
|---|---|---|---|
| ネズミキツネザル | 31 g | 45.5 | 23.2 |
| ニホンザル | 10,115 g | 53.2 | 59.9 |
| ヒト | 58,541 g | 90.1 | 71.1 |
| ヒガシゴリラ | 149,325 g | 159.2 | 77.1 |
偏差値159 という数字
まともなテストでは出てこない値である。だが計算は何も壊れていない。 導出③のとおり、偏差値の計算に分布の形は一切関係しない(標準偏差が0でなければ必ず計算できる)。 159.2 は「平均より約10.9 SD 上」という事実を、そのまま表している。
仮定が要るのは、その先である。「偏差値60だから上位約16%」のように 百分位に読み替えるときに、はじめて分布の形についての仮定が必要になる。
そして反対の端も見てほしい。31gのネズミキツネザル(45.5)と10kgのニホンザル(53.2)は、たった8しか違わない。体重は324倍も違うのにである (表示は丸めてあるが、元の値は 31.23 g と 10,114.76 g で、10,114.76 ÷ 31.23 = 約324)。
上は青天井、下は潰れる。対数の目盛りに変えれば全部 23〜78 に収まる。同じ種の同じ体重で、変えたのはものさしだけ。
偏差値の読み方
偏差値60 = 平均より1SD上。ここまではどんな分布でも正しい。 これを「上位約16%」と読み替えてよいのは、分布が正規に近いときだけである。
偏差値は「値の大きさ」ではなく「集団の中での位置」。 計算(標準化)と、百分位への読み替えを分けて考えること。
4. 正規分布と 68-95-99.7 則
正規分布は、左右対称な釣鐘型をした特定の分布である(左右対称で釣鐘型ならどれも正規、ではない)。正規分布なら、ばらつきの目安が決まっている:
| 範囲 | 理論 | 対数体重(実データ) | 生の体重(実データ) |
|---|---|---|---|
| 平均 ±1SD | 約 68% | 71.7% | 97.4% |
| 平均 ±2SD | 約 95% | 94.7% | 97.4% |
| 平均 ±3SD | 約 99.7% | 100.0% | 98.5% |
生の体重で ±1SD と ±2SD が同じ 97.4% になっているのは、誤植ではない
範囲を広げたのに1種も増えていない。理由は2つある。
- 下側はもともと空っぽ。平均 −1SD が −7,254 g なので、下に広げても入る種はいない
- 上側に空白がある。+1SD(19,016 g)から +2SD(32,150 g)のあいだに、該当する種が1種もない
実際、この帯の外側(+2SD〜+3SD)にはピグミーチンパンジー 35,120 g、チンパンジー 45,000 g、 スマトラオランウータン 39,696 g の3種がいて、だから ±3SD では 98.5% に増える。
ヒストグラムに穴があいているということであり、これ自体が「この分布は釣鐘型ではない」 という証拠になっている。釣鐘型なら、平均の近くから外へ向かって、途切れずになだらかに減っていくはずである。
対数の目盛りにした体重は、この3つの区間についてはほぼこの通りになる(歪度 −0.40)。
「中央の区間が合う」=「正規分布でよい」ではない
今回そろったのは平均±1・2・3SDに入る割合であって、分布のすべてではない。 実際、対数体重で偏差値60を超えるのは265種中28種(10.6%)で、 正規分布から予想される約15.9%とは差がある。
どの確率を、どれくらいの誤差で近似したいのかを決めないと、近似の良し悪しは判断できない。
一方、生のスケール(歪度 +7.60)はまったく合っていない。
5. 正規分布は「仮定」であって、自然法則ではない
世の中のすべてが正規分布ではない。生のスケールの体重に正規分布を当てはめると――
- 体重の歪度は +7.60(強く右に裾を引く)。対数にした後の −0.40 とは別世界。
- 釣鐘型の正規曲線は、体重のヒストグラムにまったく合わない。
- そして 平均 − 1SD = −7,254 g。体重がマイナスの動物はいない。当てはめた時点で、ありえない領域に確率を配ってしまっている。
正直に言うと、対数にしても「正規分布」ではない
厳密に検定すると(Shapiro-Wilk)、対数スケールでも有意水準5%で正規性の帰無仮説が棄却される。 検定が答えているのは「正規分布から得られたデータだという仮説を捨てるか」であって、 近似が目的に対して十分かどうかではない(検定とp値は第8回で扱う・ここは発展)。妊娠期間日も歪度がほぼ0(−0.06)で見た目は左右対称なのに、山が尖りすぎていて棄却される。
左右対称であることと、正規分布であることは、同じではない。
では対数変換は無駄だったのか。そうではない。±1SDの実測が 97.4% → 71.7%(理論68%)まで近づいたのは事実で、生のスケールよりはるかに使える。
正規分布は「現実の姿」ではなく「近似の道具」である。問うべきは「正規分布か(Yes/No)」ではなく、「この目的に対して、十分な近似か」。
「正規だと仮定する」ことの責任
68-95-99.7則や、後で習う多くの手法は「正規分布である」ことを前提にしている。歪んだデータにそれを当てると、間違った結論になる。 「正規分布だと仮定する」のは中立な前提ではなく、根拠を示すべき判断だ。まずヒストグラムを描いて形を見る、が鉄則。
まとめ
| 概念 | ひとこと |
|---|---|
| 分散 | 平均からの差を二乗して平均(単位は元の二乗) |
| 標準偏差(SD) | 分散のルート。ばらつきの標準的な幅(元の単位) |
| 偏差値 | 平均50・SD10に置き直した相対位置。計算はどんな分布でもできる。上位何%かに読み替えるときだけ分布の仮定が要る(ゴリラ159) |
| 68-95-99.7則 | 正規分布なら±1/2/3SDに68/95/99.7%(正規のときだけ) |
平均は「位置」、SDは「幅」。両方見て初めてデータが分かる。 正規分布は便利な仮定だが、当てはまるかは自分で確かめるもの。
同じデータでも、ものさしを変えれば偏差値は159にも77にもなる。 数字が出てきたら、どんな仮定の上で計算されたのかを問う。
今日の課題(Moodle提出)
配点:100点(選択40点 + 記述60点)/ 提出先:Moodle / 提出期限:次回授業の開始時刻まで
Colab 03_variability.ipynb を実行したうえで答えること。
パートA:選択問題(各10点 ×4=40点)
A1. 2つのクラスはどちらも平均60点。クラスXのSDは3点、クラスYのSDは25点だった。正しいのは?
- (ア) XとYは平均が同じなので、ほぼ同じクラスだ
- (イ) Yのほうが点のばらつきが大きい。ただし、極端な点の人数や分布の形までは平均とSDだけでは分からない
- (ウ) Xのほうがばらつきが大きい
A2. 標準偏差について正しいのは?
- (ア) 標準偏差は小さいほど良いクラスだといえる
- (イ) 標準偏差は「平均からの標準的な散らばりの幅」を表す
- (ウ) 標準偏差は平均と同じ意味で、どちらを使ってもよい
A3. あるテストは平均60点・標準偏差8点だった。76点を取った人の偏差値に最も近いのは?
- (ア) 50 (イ) 60 (ウ) 70 (エ) 80
A4. 「対数目盛りの体重では68-95-99.7則がだいたい成り立ったが、生の体重では成り立たなかった」。その理由として最も適切なのは?
- (ア) 生の体重はデータ数が少なかったから
- (イ) 生の体重の分布は右に大きく歪んでおり、この規則による区間割合の近似が合わないから
- (ウ) 68-95-99.7則はお金には使えない決まりだから
パートB:記述問題(AIフィードバック対象・60点)
【全記述に共通・重要】自分のノートの数字を引用すること
各記述には、今日のColabで確認した数値を最低1つ引用すること(例:「妊娠期間日のSDは37.8日」「対数体重は±2SDに94.7%」「生の体重の歪度は+7.60」「ゴリラの偏差値は159.2」)。 引用がない記述は、内容が良くても満点にはなりません。
B1.(30点) ある会社が2つの工場A・Bの製品の重さを測ったところ、どちらも平均500gだったが、AのSDは2g、BのSDは40gだった。「平均が同じだから品質も同じ」と言えるか。SDの意味に触れながら、どちらの工場が安定しているか、その理由とともに説明しなさい。
B2.(30点) 「対数目盛りの体重には正規分布(68-95-99.7則)がだいたい使えたのに、生の体重には使えなかった」のはなぜか。分布の形(歪み)という言葉を使って説明し、「データを見たら何でも正規分布だと仮定してよいわけではない」とはどういうことかを、自分の言葉で述べなさい。
目安:B1・B2あわせて300〜500字。自分の言葉で書くこと。
字数は目安です。多少の過不足で減点はしません。見るのは、設問が挙げた要素(上の箇条書き)が書けているかどうかです。ただし要素が抜けていれば、その分は引きます。
次回予告
第4回「Python統計処理入門」。ここまで見てきた代表値・ばらつきを、いよいよ自分でコードを書いて求める。Colab・Pandas・NumPy の本格始動。